

Разработчики систем распознавания документов работают с искусственным интеллектом уже несколько десятилетий. Технологии оптического распознавания символов (OCR), обработки естественного языка (NLP) и машинное обучение (ML) применялись в решениях для интеллектуальной обработки документов (IDP) задолго до появления генеративных моделей. На этой технологической базе построена IDP-платформа ContentCapture компании Content AI. За это время она эволюционировала от инструмента извлечения данных в систему сквозной автоматизации работы с документами. С 2025 года ее архитектура включает большие языковые модели, а недавно в платформе появились инструменты роботизации.
ИИ первого поколения: что умела платформа с самого начала
ContentCapture создавалась как решение для потоковой обработки документов, и искусственный интеллект был заложен в основание платформы.
Собственный OCR-движок распознает различные типы и форматы документов на разных языках, понимает рукописный текст и работает с документами со сложным фоном, например с паспортами.
ML-модели обеспечивают анализ структуры документа и применяют разные методы обработки к разным элементам: текстовый блок обрабатывается как текст, таблица — как таблица, штрихкод — как штрихкод. Отдельные предобученные модели участвуют в подготовке изображения к распознаванию — исправляют перекосы, возникшие в ходе сканирования, улучшают контрастность и убирают случайные шумы.
Третий ключевой компонент — технологии обработки естественного языка (NLP). Они участвуют в распознавании неструктурированных документов и понимают их содержание с учетом контекста. Именно NLP позволяет ContentCapture находить в договорах нужные реквизиты даже тогда, когда содержащий их блок расположен в нестандартном месте.
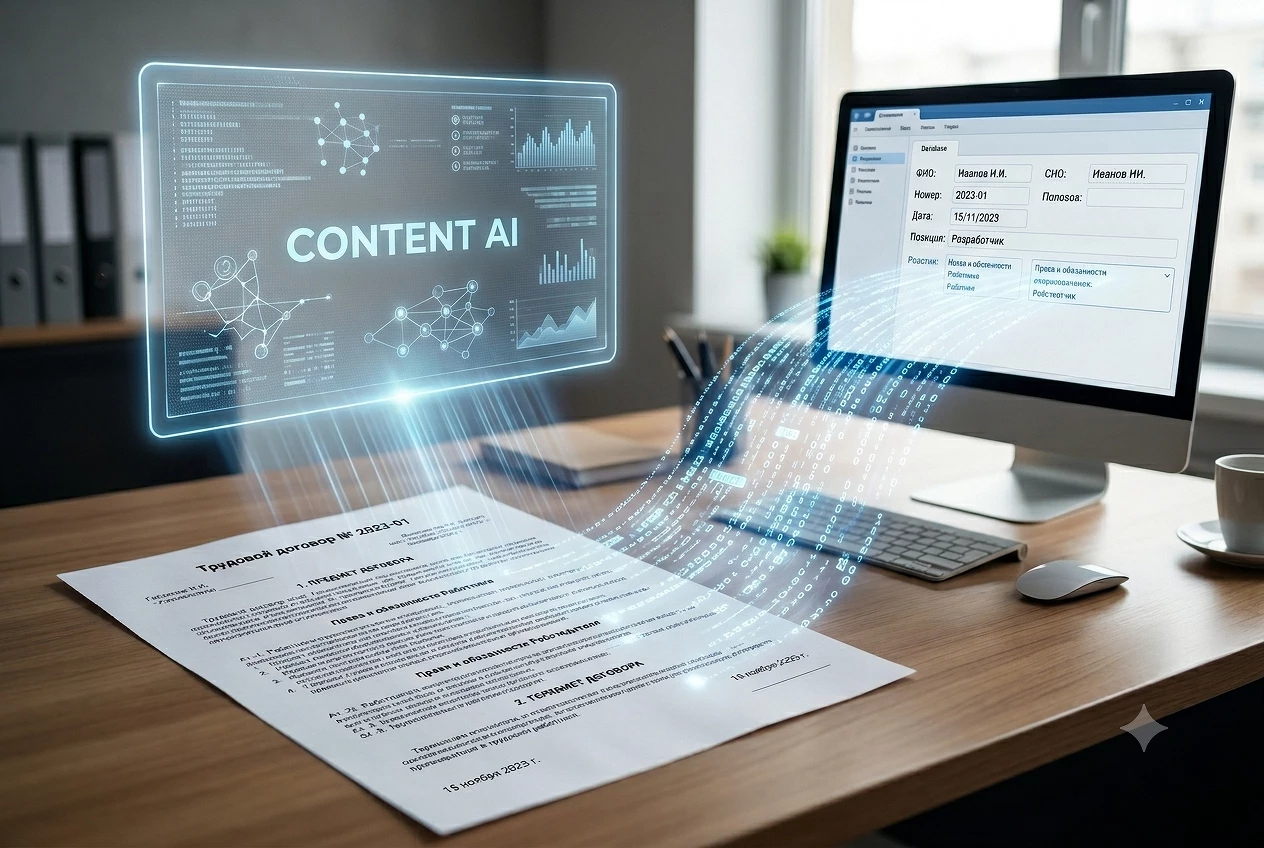
За счет комбинации этих технологий ContentCapture обеспечивает полный цикл обработки документов. Платформа принимает файлы со сканера, из электронной почты или специальной папки, автоматически определяет тип документа — счет, акт, УПД, товарная накладная, — извлекает нужные данные и после верификации оператором передает их в 1С, клиентские базы (CRM), системы планирования ресурсов (ERP) или другие корпоративные учетные системы.
Большие языковые модели в архитектуре платформы
Долгое время платформа специализировалась на обработке структурированных и полуструктурированных документов — счетов, счетов-фактур, актов, УПД, платежных поручений. Со временем у заказчиков появилась потребность в обработке неструктурированных документов — договоров, протоколов, доверенностей, судебных решений, инструкций. Структура этих документов вариативна, и классические методы распознавания давали сбой. Здесь требовался иной подход, и решением стала интеграция с большими языковыми моделями.
В начале 2025 года в ContentCapture появилась поддержка облачных больших языковых моделей (LLM) YandexGPT и GigaChat. Чуть позднее реализована поддержка локальных LLM через фреймворк Ollama, открывающий доступ к открытым моделям. После предварительного обучения платформа в связке с LLM достигает точности извлечения данных из неструктурированных документов в 98%.
В Content AI считают, что на данном этапе наиболее прагматичным решением для заказчика будет гибридная архитектура, в которой большие языковые и мультимодальные модели дополняют классические технологии.
«Большие языковые и мультимодальные модели вполне справляются с распознаванием документов и извлечением данных. Но без специальной «обвязки» в виде инструментов настройки процессов, контроля и безопасности применять их в корпоративной среде напрямую не получится. Оптимальный путь — это связка IDP-решений с большими языковыми моделями, — поясняет главный владелец продукта ContentCapture Антон Хаймовский. — У каждого подхода есть своя область применения. NLP качественно обрабатывает шаблонные документы. LLM подключается при распознавании документов с вариативной структурой или с большим количеством визуального «мусора» из рукописных пометок или штампов».
Важную роль в гибридной архитектуре играет дистилляция. Ее суть заключается в применении компактных специализированных моделей, обученных на синтетических данных и на основе логики крупных передовых моделей, для распознавания конкретных типов документов. Причем подготовить дистиллированную модель для работы с новым видом соглашения и коммерческого предложения можно буквально за считанные часы. Таким образом компания может масштабировать обработку с помощью ИИ на основе довольно скромной инфраструктуры.
Гибридный подход выгоден заказчикам и с экономической точки зрения. Работа исключительно на больших языковых моделях требует дорогостоящих серверных мощностей с графическими процессорами (GPU). IDP-решения обеспечивают сопоставимый результат на центральном процессоре (CPU), и это существенно снижает стоимость внедрения и владения.
Гибридный подход на практике
Именно такой подход интеграции IDP и LLM применен в проектах автоматизации обработки судебных документов в энергосбытовых компаниях Москвы и Тюмени, реализованных Content AI совместно с интегратором «ЕСМ-Консалтинг».
Энергосбытовая компания Москвы ежедневно получала до 2000 различных судебных документов — приказов, определений суда и постановлений ФССП. Каждое судебное ведомство применяет собственные форматы, значительно различающиеся по структуре. Архитектура решения строилась на разделении задач по типу данных. Структурированные поля из шапки документов — дата решения, номер дела — решено обрабатывать классическими IDP- инструментами, поскольку их местоположение известно. Основной текст — номера лицевых счетов, периоды взысканий, сведения о должниках — передается в YandexGPT, которая извлекает нужные данные и возвращает результат в структурированном виде. По итогам внедрения скорость обработки судебных документов выросла в три раза, и это помогло повысить скорость претензионной работы ведомств в целом.
Сквозная автоматизация с помощью программных роботов
В большинстве бизнес-процессов распознавание документа — только стартовый пункт последующей цепочки действий. После извлечения данных необходимо направить документ на согласование, создать запись в ERP или обновить реестр. Автоматизация такого цикла с участием нескольких специалистов и корпоративных систем требует интеграции IDP-решения с инструментами роботизации (RPA). По оценке Content AI, это увеличивает стоимость проекта распознавания документов в среднем на 30–50%. Чтобы оптимизировать затраты заказчиков, разработчик встроил инструменты роботизации непосредственно в платформу ContentCapture.
«С появлением собственных RPA-инструментов ContentCapture смогла охватить более широкий спектр офисных операций. Сегодня платформа работает с файловой системой, облачными хранилищами, корпоративными базами знаний, а также при необходимости взаимодействует с браузером, электронной почтой, CRM, СЭД, ERP. Таким образом достигается сквозная автоматизация процесса. Она начинается с момента распознавания поступившего документа и завершается целевым действием, например оплатой счета или подготовкой ответа на обращение», — поясняет Антон Хаймовский.
Один из востребованных сценариев применения IDP и RPA — обработка входящих обращений. После поступления письма или заявки ContentCapture автоматически определяет тип и суть обращения, присваивает ему нужную категорию и направляет ответственному исполнителю. Другой сценарий — формирование пакета документов по шаблонам. В рамках этого сценария платформа забирает данные из учетной системы или CRM, генерирует готовые документы и отправляет их адресату или сохраняет пакет в другой информационной системе. Все рутинные операции выполняются автоматически, сотрудники же только проверяют и корректируют результат. По расчетам Content AI, скорость выполнения типовых операций вырастает в 5–10 раз.
Для настройки собственных сценариев автоматизации в платформе реализован инструментарий генерации кода (вайб-кодинг). «Пользователю достаточно описать задачу, чтобы агент сгенерировал и протестировал код для сценариев автоматизации ContentCapture. Это упрощает работу интеграторов и в ряде случаев позволяет заказчику настраивать сценарии самостоятельно», — комментирует Антон Хаймовский.
Безопасность на всех уровнях платформы
IDP-платформа работает с документами, которые содержат персональные данные и коммерческую тайну. Поэтому для крупных заказчиков остро стоит вопрос соответствия решения требованиям информационной безопасности.
Для интеграции с корпоративной инфраструктурой в ContentCapture поддерживаются единый вход и доменная аутентификация. Технология единого входа (SSO) реализована по нескольким стандартам, в т.ч. по протоколам SAML 2.0, OIDC и JWT. Подключение выполняется через поставщиков удостоверений Keycloak или Active Directory, включая сценарии с Kerberos. Политики паролей, многофакторная аутентификация (MFA) и жизненный цикл учетных записей остаются на стороне заказчика. Для базовой аутентификации и доступа по программному интерфейсу (API) настраивается парольная политика с возможностью блокировки при превышении числа неудачных попыток входа.
События безопасности экспортируются в стандартном формате для передачи событий безопасности (CEF) для дальнейшей обработки в корпоративных системах управления событиями и инцидентами (SIEM). Защита данных выстраивается на уровне инфраструктуры и приложения: трафик передается по шифрованным каналам протоколов защищенной передачи данных (HTTPS/TLS), для RPA поддерживается взаимная аутентификация (mTLS), для веб-станций применяются политики защиты контента (CSP) и принудительного использования защищенного соединения (HSTS). Данные при хранении шифруются средствами системы управления базами данных (СУБД) и файлового хранилища, включая объектное хранилище (S3). Резервное копирование выполняется без остановки обработки документов.
Отдельный вопрос в рамках ИИ-проектов, куда уходят документы при работе с языковыми моделями. ContentCapture поддерживает локальные модели, развернутые на инфраструктуре заказчика. При подключении облачных моделей администратор системы контролирует, какие сценарии обработки получают доступ к внешним API, а журнал событий фиксирует обращения к моделям.
Практика крупных внедрений
Масштаб реальных внедрений служит одним из главных доказательств зрелости платформы. Показательный пример — миграция Россельхозбанка с иностранной IDP-системы на ContentCapture. РСХБ в среднем ежегодно обрабатывает около 12 млн документов. Клиенты банка с разветвленной региональной сетью обращаются за кредитами, открытием счетов и депозитов. При выборе нового решения банк остановился на платформе ContentCapture, поскольку она способна обеспечивать необходимую производительность и точность распознавания при таком объеме.
Перед стартом команда банка провела детальный аудит ИТ-инфраструктуры и проанализировала все интеграции и кастомные скрипты. Миграция заняла девять месяцев и проходила поэтапно во всех филиалах банка. Перед запуском в эксплуатацию был развернут тестовый контур, на котором проверялась обработка свыше 130 видов документов.
Внедрить новое решение удалось без остановки операционных процессов. Сегодня ContentCapture стабильно обрабатывает более 1 млн документов в месяц и помогает в работе свыше 15 тысяч операционистов по всей стране.
«Россельхозбанк одним из первых в 2024 году внедрил решение ContentCapture на российской операционной системе и СУБД. Система применяется при работе с клиентами для сканирования и распознавания документов с последующим автоматическим заполнением полей в учетных системах. За время эксплуатации мы убедились в правильности выбора программного комплекса, так как решение показывает быструю, стабильную работу, сохраняя качество обработки документов даже при значительных объемах, которые генерирует банк», — отметил Михаил Пушкарёв, руководитель управления развития систем контент-менеджмента и ЭДО РСХБ.Цифра (Россельхозбанк).
ContentCapture прошла путь, который отражает развитие всего IDP-рынка. Начиная как специализированный инструмент распознавания, сегодня она эволюционировала в платформу, способную автоматизировать различные бизнес-процессы. Большие языковые модели и инструменты роботизации расширили ее возможности, но сохранили главный принцип — обеспечение надежной и безопасной работы с документами в корпоративной среде.
«Мы строили платформу на основе запросов рынка, и каждая используемая технология — OCR, NLP, ML, LLM, RPA — призвана решать конкретные задачи бизнеса. ContentCapture сегодня охватывает полный цикл работы с документами, и у нас есть понимание, куда двигаться дальше», — резюмирует Антон Хаймовский.
■ Рекламаerid:2W5zFKA5da9Рекламодатель: OOO "Контент ИИ"ИНН/ОГРН: 9715416652/1227700186174Сайт: https://contentai.ru Поделиться